Generative Adversarial Networks (GAN)
This tutorial demonstrates how to build and train a Generative Adversarial Network (GAN) on real MNIST handwritten digits using separate Generator and Discriminator modules in Taktiny.
Because Taktiny models are registered JAX PyTrees, coordinating multi-model optimization—such as alternating generator and discriminator updates with independent Optax optimizers—is transparent, flexible, and idiomatic.
You will learn how to:
Construct Generator and Discriminator networks as independent
taktiny.nn.ModulePyTrees.Load and preprocess real handwritten digits from Hugging Face
datasets(MNIST) usingtaktiny.data.DataLoader.Configure dual independent Optax optimizers.
Implement an alternating minimax adversarial training step compiled with
jax.jit.Apply one-sided label smoothing to prevent discriminator saturation.
Sample and visualize newly synthesized digits using
matplotlib.
1. Install Taktiny
If Taktiny isn’t installed in your Python environment, you can install Taktiny from GitHub by using either pip or uv:
uv add -U git+https://github.com/solitariusai/taktiny.git@experiment
# or
# pip install -U git+https://github.com/solitariusai/taktiny.git@experiment
2. Import Packages
import jax
import jax.numpy as jnp
import matplotlib.pyplot as plt
import numpy as np
import optax
from datasets import load_dataset

from taktiny import nn
from taktiny.data import Batch, DataLoader, Map
3. Define Generator and Discriminator Models
We define the Generator and Discriminator as separate nn.Module classes:
Generator: Projects a low-dimensional latent noise vector \(z \sim \mathcal{N}(0, I)\) into a flattened image \(\hat{x} \in [-1, 1]^{784}\) usingtanh.Discriminator: Evaluates an image vector \(x \in \mathbb{R}^{784}\) and outputs an unnormalized scalar logit indicating whether the image is real (\(1\)) or synthetic (\(0\)).
class Generator(nn.Module):
    """Maps latent noise vectors z to synthetic flattened image space."""
    def __init__(self, latent_dim: int, *, rngs: nn.Rngs):
        self.fc1 = nn.Linear(latent_dim, 256, rngs=rngs)
        self.fc2 = nn.Linear(256, 512, rngs=rngs)
        self.fc3 = nn.Linear(512, 784, rngs=rngs)

    def __call__(self, z: jax.Array) -> jax.Array:
        h = jax.nn.leaky_relu(self.fc1(z), negative_slope=0.2)
        h = jax.nn.leaky_relu(self.fc2(h), negative_slope=0.2)
        return jnp.tanh(self.fc3(h))

class Discriminator(nn.Module):
    """Classifies whether an input image is real (1) or generated (0)."""
    def __init__(self, *, rngs: nn.Rngs):
        self.fc1 = nn.Linear(784, 512, rngs=rngs)
        self.fc2 = nn.Linear(512, 256, rngs=rngs)
        self.fc3 = nn.Linear(256, 1, rngs=rngs)

    def __call__(self, x: jax.Array) -> jax.Array:
        h = jax.nn.leaky_relu(self.fc1(x), negative_slope=0.2)
        h = jax.nn.leaky_relu(self.fc2(h), negative_slope=0.2)
        return self.fc3(h)

# Initialize models
latent_dim = 64
rngs = nn.Rngs(42)

generator = Generator(latent_dim=latent_dim, rngs=rngs)
discriminator = Discriminator(rngs=rngs)

print(generator)
print(discriminator)
Generator (550.42K, 2.1 MB)
├── fc1: Linear(64 ➤ 256) (16.64K, 65 KB)
│   ├── kernel: f32[64, 256]
│   └── bias: f32[256]
├── fc2: Linear(256 ➤ 512) (131.58K, 514 KB)
│   ├── kernel: f32[256, 512]
│   └── bias: f32[512]
└── fc3: Linear(512 ➤ 784) (402.19K, 1.53 MB)
    ├── kernel: f32[512, 784]
    └── bias: f32[784]
Discriminator (533.5K, 2.04 MB)
├── fc1: Linear(784 ➤ 512) (401.92K, 1.53 MB)
│   ├── kernel: f32[784, 512]
│   └── bias: f32[512]
├── fc2: Linear(512 ➤ 256) (131.33K, 513 KB)
│   ├── kernel: f32[512, 256]
│   └── bias: f32[256]
└── fc3: Linear(256 ➤ 1) (257, 1 KB)
    ├── kernel: f32[256, 1]
    └── bias: f32[1]
4. Load the MNIST Dataset
We load the real MNIST dataset from Hugging Face datasets. Because the Generator uses tanh as its output activation, pixel values in \([0, 255]\) are normalized to \([-1.0, 1.0]\) and flattened to shape (784,):
# Load MNIST dataset
raw_train = load_dataset("ylecun/mnist", split="train")

# Normalize PIL images to [-1.0, 1.0] and flatten to (784,)
def preprocess(item: dict) -> dict[str, np.ndarray]:
    img = np.array(item["image"], dtype=np.float32) / 127.5 - 1.0
    return {"x": img.reshape(784)}

# Build DataLoader with mapping and batching
train_loader = DataLoader(
    raw_train,
    operations=[Map(preprocess), Batch(batch_size=64)],
)
5. Setting Up Independent Optimizers
Because the Discriminator and Generator have competing dynamics, we configure two independent Optax optimizers and track their states separately. This avoids optimizer momentum pollution:
g_opt = optax.adam(learning_rate=2e-4, b1=0.5)
d_opt = optax.adam(learning_rate=2e-4, b1=0.5)

g_opt_state = g_opt.init(generator)
d_opt_state = d_opt.init(discriminator)
6. Alternating Minimax Training Step
In GAN training, alternating updates stabilize optimization:
Discriminator Step: Evaluate real and fake samples, compute loss \(L_D\), and update the Discriminator weights.
We apply one-sided label smoothing (
0.9instead of1.0for real targets) to prevent discriminator logits from blowing up and freezing generator gradients.
Generator Step: Generate fake samples and evaluate them against the updated Discriminator, compute non-saturating loss \(L_G\), and update the Generator weights.
We compile the entire dual-step sequence into a single jax.jit function:
@jax.jit
def train_step(
    generator: Generator,
    discriminator: Discriminator,
    g_opt_state: optax.OptState,
    d_opt_state: optax.OptState,
    real_batch: jax.Array,
    noise_batch: jax.Array,
):
    # -------------------------------------------------------------
    # 1. Update Discriminator: maximize log(D(x)) + log(1 - D(G(z)))
    # -------------------------------------------------------------
    def d_loss_fn(d_model: Discriminator) -> jax.Array:
        fake_batch = generator(noise_batch)
        d_real_logits = d_model(real_batch)
        d_fake_logits = d_model(fake_batch)

        # One-sided label smoothing for real images
        loss_real = optax.sigmoid_binary_cross_entropy(
            logits=d_real_logits, labels=jnp.full_like(d_real_logits, 0.9)
        )
        loss_fake = optax.sigmoid_binary_cross_entropy(
            logits=d_fake_logits, labels=jnp.zeros_like(d_fake_logits)
        )
        return jnp.mean(loss_real + loss_fake)

    d_loss, d_grads = jax.value_and_grad(d_loss_fn)(discriminator)
    d_updates, d_opt_state = d_opt.update(d_grads, d_opt_state, discriminator)
    discriminator = optax.apply_updates(discriminator, d_updates)

    # -------------------------------------------------------------
    # 2. Update Generator: maximize log(D(G(z))) against updated D
    # -------------------------------------------------------------
    def g_loss_fn(g_model: Generator) -> jax.Array:
        fake_batch = g_model(noise_batch)
        d_fake_logits = discriminator(fake_batch)
        return jnp.mean(
            optax.sigmoid_binary_cross_entropy(
                logits=d_fake_logits, labels=jnp.ones_like(d_fake_logits)
            )
        )

    g_loss, g_grads = jax.value_and_grad(g_loss_fn)(generator)
    g_updates, g_opt_state = g_opt.update(g_grads, g_opt_state, generator)
    generator = optax.apply_updates(generator, g_updates)

    return generator, discriminator, g_opt_state, d_opt_state, d_loss, g_loss
7. Running the Training Loop
We iterate over batches from DataLoader, sampling fresh latent noise vectors at each step:
num_epochs = 20
step = 0
key = jax.random.key(123)

for epoch in range(num_epochs):
    for batch in train_loader:
        step += 1
        key, step_key = jax.random.split(key)
        batch_noise = jax.random.normal(
            step_key, shape=(batch["x"].shape[0], latent_dim)
        )

        generator, discriminator, g_opt_state, d_opt_state, d_loss, g_loss = train_step(
            generator,
            discriminator,
            g_opt_state,
            d_opt_state,
            batch["x"],
            batch_noise,
        )

        if step % 500 == 0:
            print(
                f"Step {step:4d} ┃ "
                f"D Loss: {float(d_loss):.4f} ┃ "
                f"G Loss: {float(g_loss):.4f}"
            )
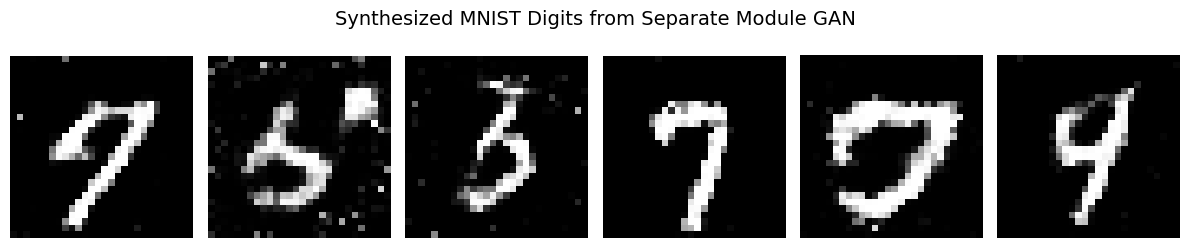
8. Generating Samples and Visualization
After training, switch the generator to evaluation mode, sample latent noise vectors, and rescale the generated pixel values from \([-1.0, 1.0]\) to \([0.0, 1.0]\):
# Switch to evaluation mode
generator.eval()

# Sample 6 latent noise vectors
eval_key = jax.random.key(777)
eval_noise = jax.random.normal(eval_key, shape=(6, latent_dim))

# Generate images and rescale to [0, 1]
generated = generator(eval_noise)
generated = (generated + 1.0) / 2.0
generated_images = generated.reshape(6, 28, 28)

# Plot generated samples
fig, axs = plt.subplots(1, 6, figsize=(12, 2.5))
for i in range(6):
    axs[i].imshow(generated_images[i], cmap="gray")
    axs[i].axis("off")

fig.suptitle("Synthesized MNIST Digits from Separate Module GAN", fontsize=14)
plt.tight_layout()
plt.show()
The generator successfully synthesizes realistic handwritten digits: